Microsoft presenta Maia 300: su nuevo chip para Copilot llegará en 2027
Microsoft prepara el salto a sus propios chips como principal infraestructura de inferencia para sus servicios de IA. Maia 300 empezará a desplegarse en 2027 y reunirá 96 aceleradores por rack.
- Noticia
- Confirmado
- Publicada el
- 3 minutos de lectura
Lo esencial
- Maia 300 se instalará en los centros de datos de Microsoft; el cambio llega a través de sus servicios de IA.
- Maia 200 ya ejecuta cargas de Copilot; GitHub Copilot y Microsoft Foundry están previstos antes de terminar 2026.
- Microsoft espera un 40 % más de tokens por megavatio frente a los principales sistemas basados en GPU.
- Cada acelerador Maia 300 tendrá 288 GB de memoria HBM4 y 18 TB/s de ancho de banda.
- 2027Inicio del despliegue
- 288 GBMemoria por acelerador
- +40 %Tokens por megavatio
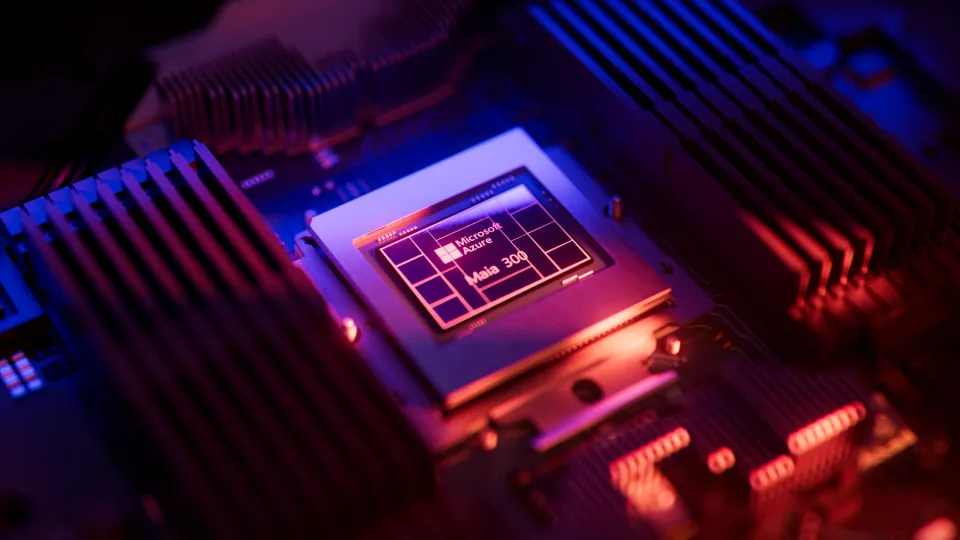
Si usas Copilot, el cambio llegará por los servidores que ejecutan sus modelos de IA. Maia 300 es un acelerador para los centros de datos de Microsoft, especializado en inferencia: el trabajo que realiza un modelo ya entrenado cuando procesa una petición y genera la respuesta. No hay nada que instalar ni que activar: el cambio ocurre en la nube.
Microsoft presentó esta tercera generación el 12 de octubre de 2026. Su plan es ampliar la familia Azure Maia a despliegues de varios gigavatios desde 2027 y convertirla en su principal sistema de inferencia. La novedad abarca el chip, los servidores, la red y la refrigeración que trabajan juntos para atender conversaciones y tareas de agentes.
Qué servicios lo usarán y cuándo
La generación anterior, Maia 200, ya da servicio a Microsoft Copilot y ejecuta modelos de OpenAI junto a los modelos MAI de la propia Microsoft. GitHub Copilot y Microsoft Foundry, la plataforma para crear y desplegar aplicaciones de IA, seguirán antes de terminar 2026, según el calendario anunciado.
Maia 300 empezará a desplegarse en producción en 2027. Microsoft lo orienta a conversaciones largas, razonamiento y agentes que encadenan varios pasos y herramientas.
Más memoria cerca del cálculo
En su descripción técnica de Maia 300, Microsoft explica que ha dividido las funciones del acelerador entre varios chips pequeños, o chiplets. Los dedicados al cálculo se fabricarán con el proceso TSMC N2P; el control de memoria y las conexiones se sitúan en otros componentes.
El objetivo es acercar los datos a la parte que los necesita. Maia 300 pasa a una organización de memoria que tiene en cuenta dónde está cada región de cálculo, en vez de tratar todos los accesos de la misma forma. El software decide cómo colocar y mover los datos entre esas regiones.
Cada acelerador incorpora ocho pilas HBM4, con 288 GB de capacidad y 18 TB/s de ancho de banda. Microsoft cifra la mejora frente a Maia 200 en 2,5 veces el ancho de banda y un 33 % más de capacidad. Esa memoria sostiene los modelos y la información que conservan mientras producen una respuesta.
El salto también está en el rack
Un rack es el armario que agrupa los servidores y sus conexiones. Maia 300 reunirá 24 bandejas con cuatro aceleradores cada una. La compañía integra en cada bandeja el procesador anfitrión, su memoria, almacenamiento y refrigeración, para aprovechar el espacio que antes ocupaban elementos separados.
| Característica | Maia 200 | Maia 300 |
|---|---|---|
| Aceleradores por rack | 48 | 96 |
| Organización de la memoria del chip | Acceso uniforme | Acceso según la ubicación de los datos |
| Situación del despliegue | En producción | Inicio previsto en 2027 |
El rack completo está diseñado para 167 kW. Como referencia, los racks GB300 de Nvidia reúnen 72 GPU y consumen unos 142 kW, según Reuters. La refrigeración líquida retirará más del 80 % de su carga térmica; el aire atenderá otros componentes, como memoria y almacenamiento.
La red se basa en Ethernet y puede unir hasta 128 racks, con 12.288 aceleradores, dentro de un mismo conjunto. Microsoft describe un sistema capaz de colocar partes de una tarea en distintos racks y recurrir a aceleradores de reserva de otro armario cuando alguno falla.
Qué significan las cifras de rendimiento
Microsoft espera un 40 % más de tokens por megavatio frente a los principales sistemas basados en GPU. Los tokens son las unidades en que el modelo procesa y genera contenido: esta comparación relaciona el trabajo producido con la potencia eléctrica disponible.
Por separado, la empresa anuncia hasta siete veces el volumen de tokens por rack respecto a Maia 200, con la configuración completa de 96 aceleradores. Esa cifra compara armarios enteros: el nuevo reúne el doble de aceleradores. Por vatio, Microsoft calcula más de 2,5 veces el rendimiento de Maia 200. Para el 40 %, no ha dicho con qué sistemas de GPU lo compara.
El siguiente hito es Microsoft Ignite, del 17 al 20 de noviembre de 2026, en San Francisco y por internet. Microsoft prevé compartir allí más información sobre su estrategia de IA y adopción de estas tecnologías.